时间:2026-10-10 点击: 次 来源:网络 作者:佚名 - 小 + 大
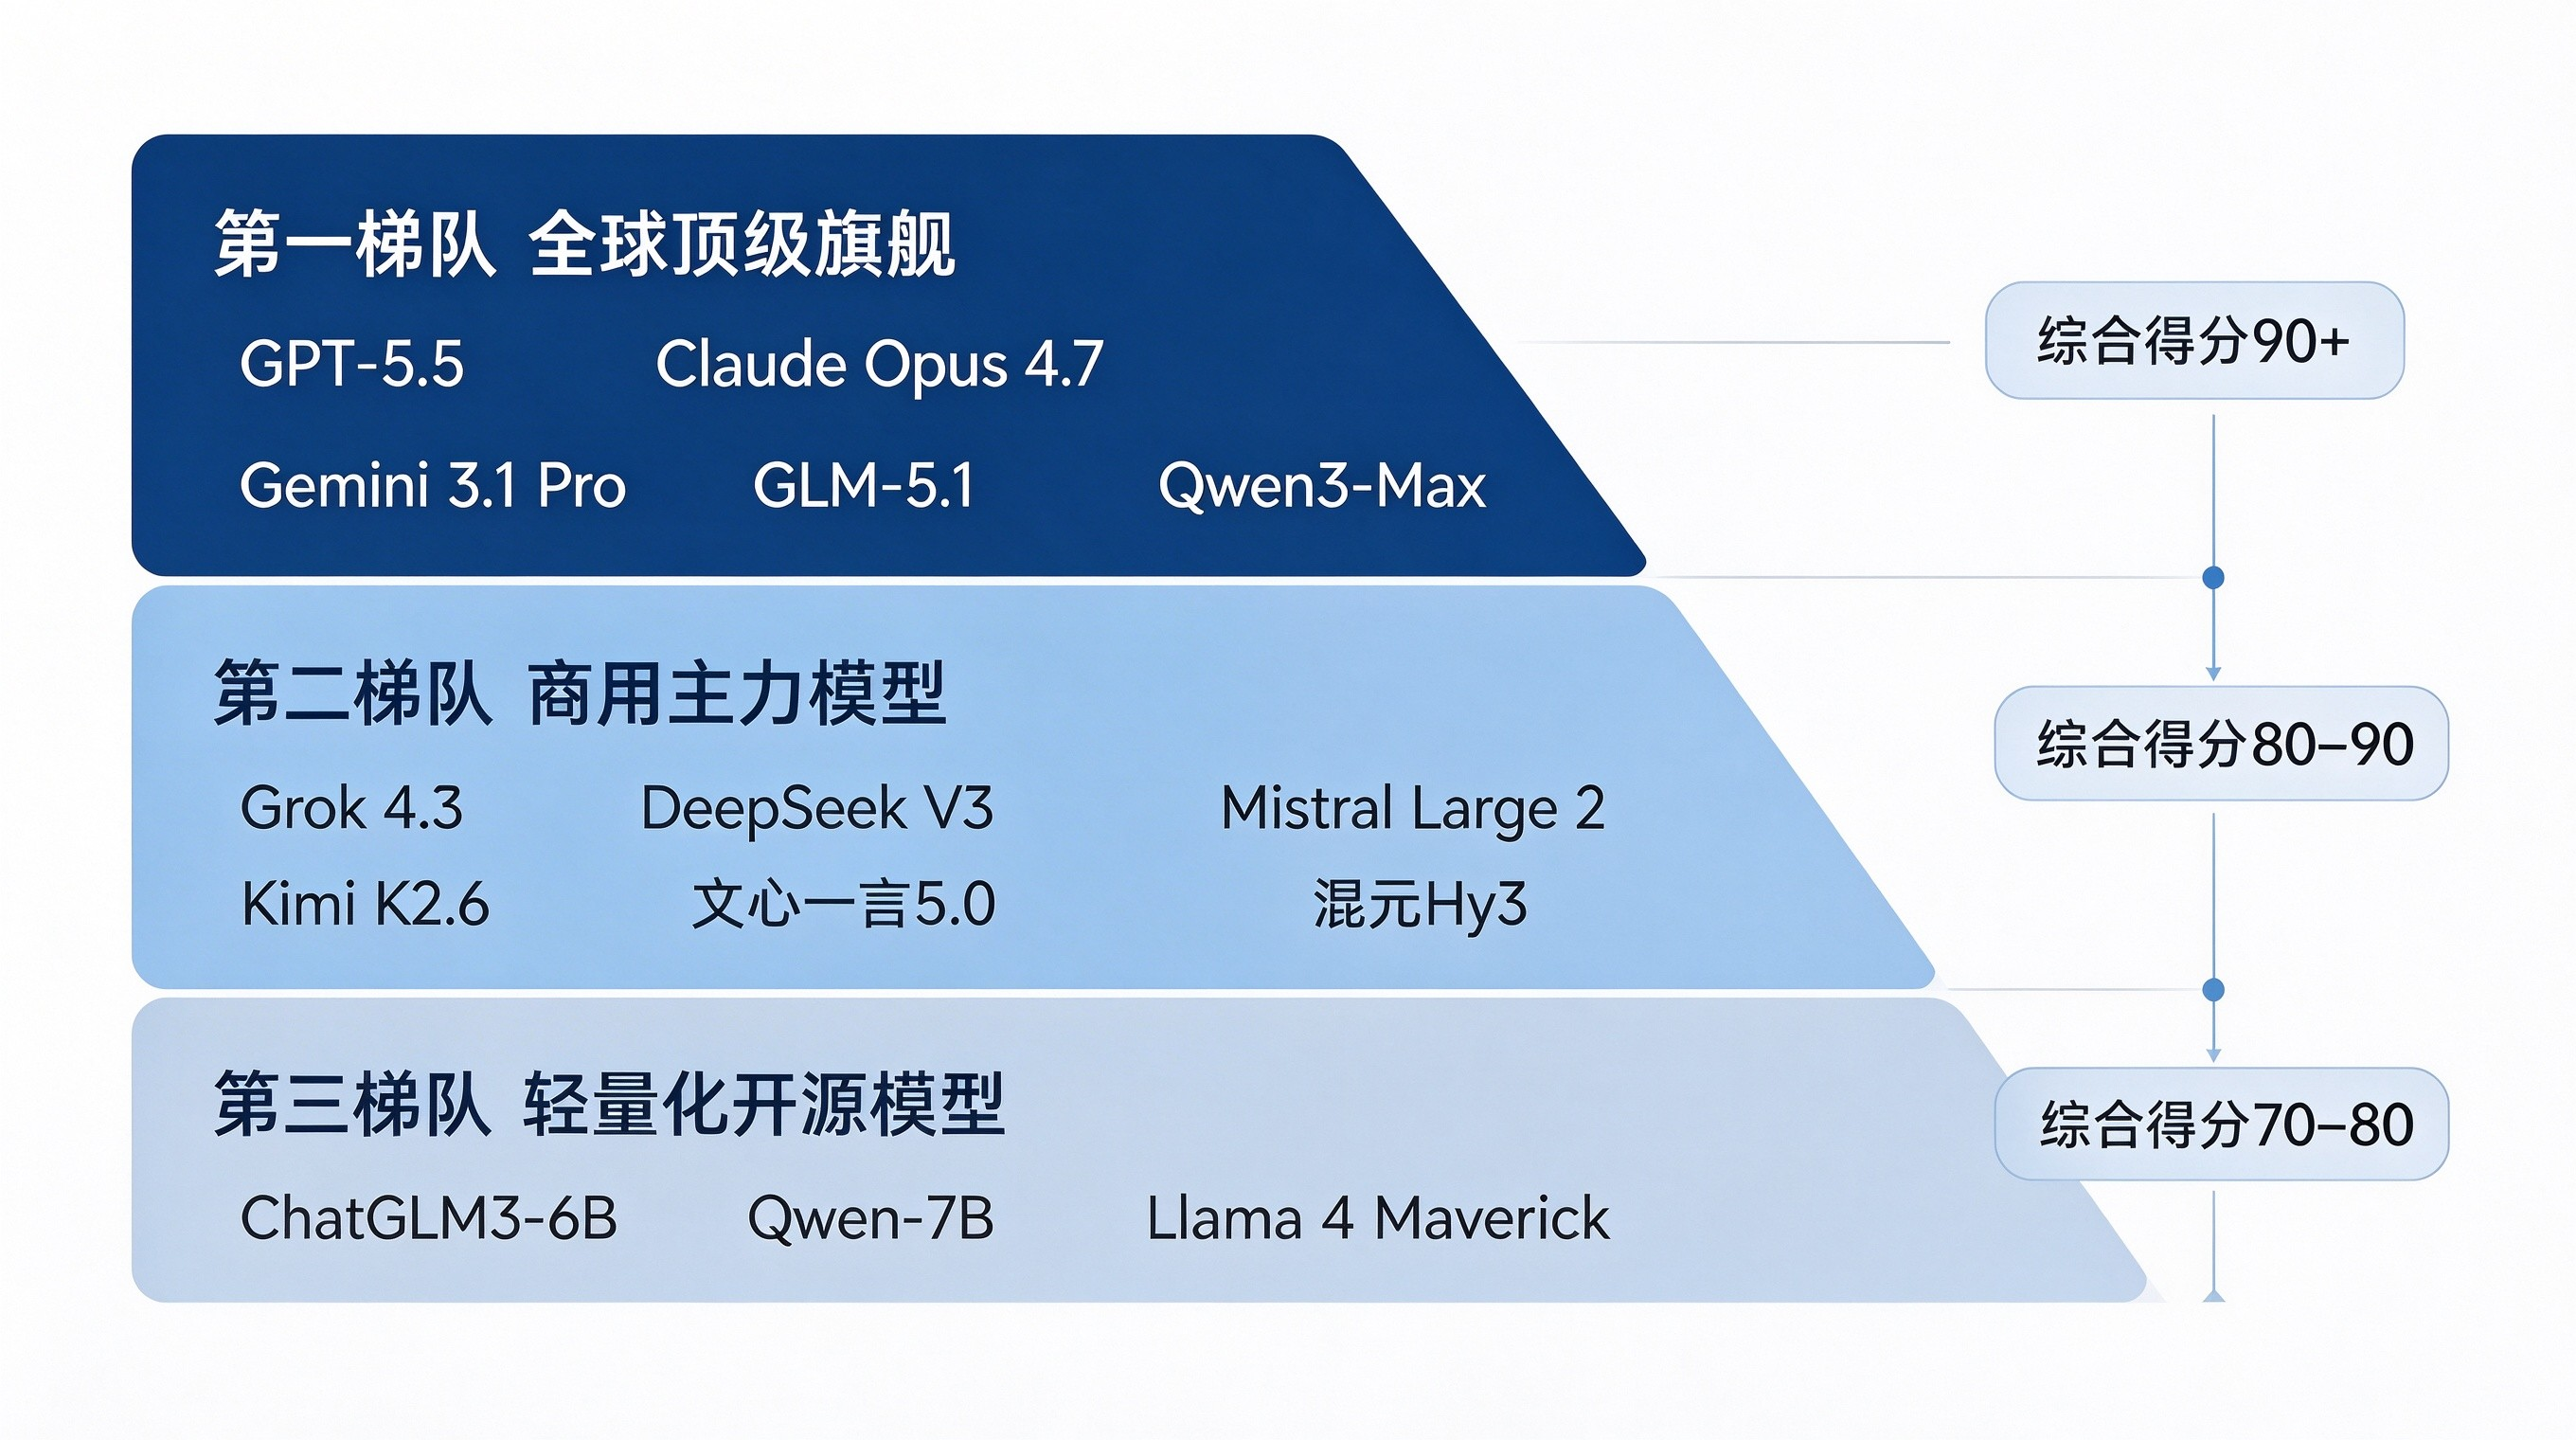
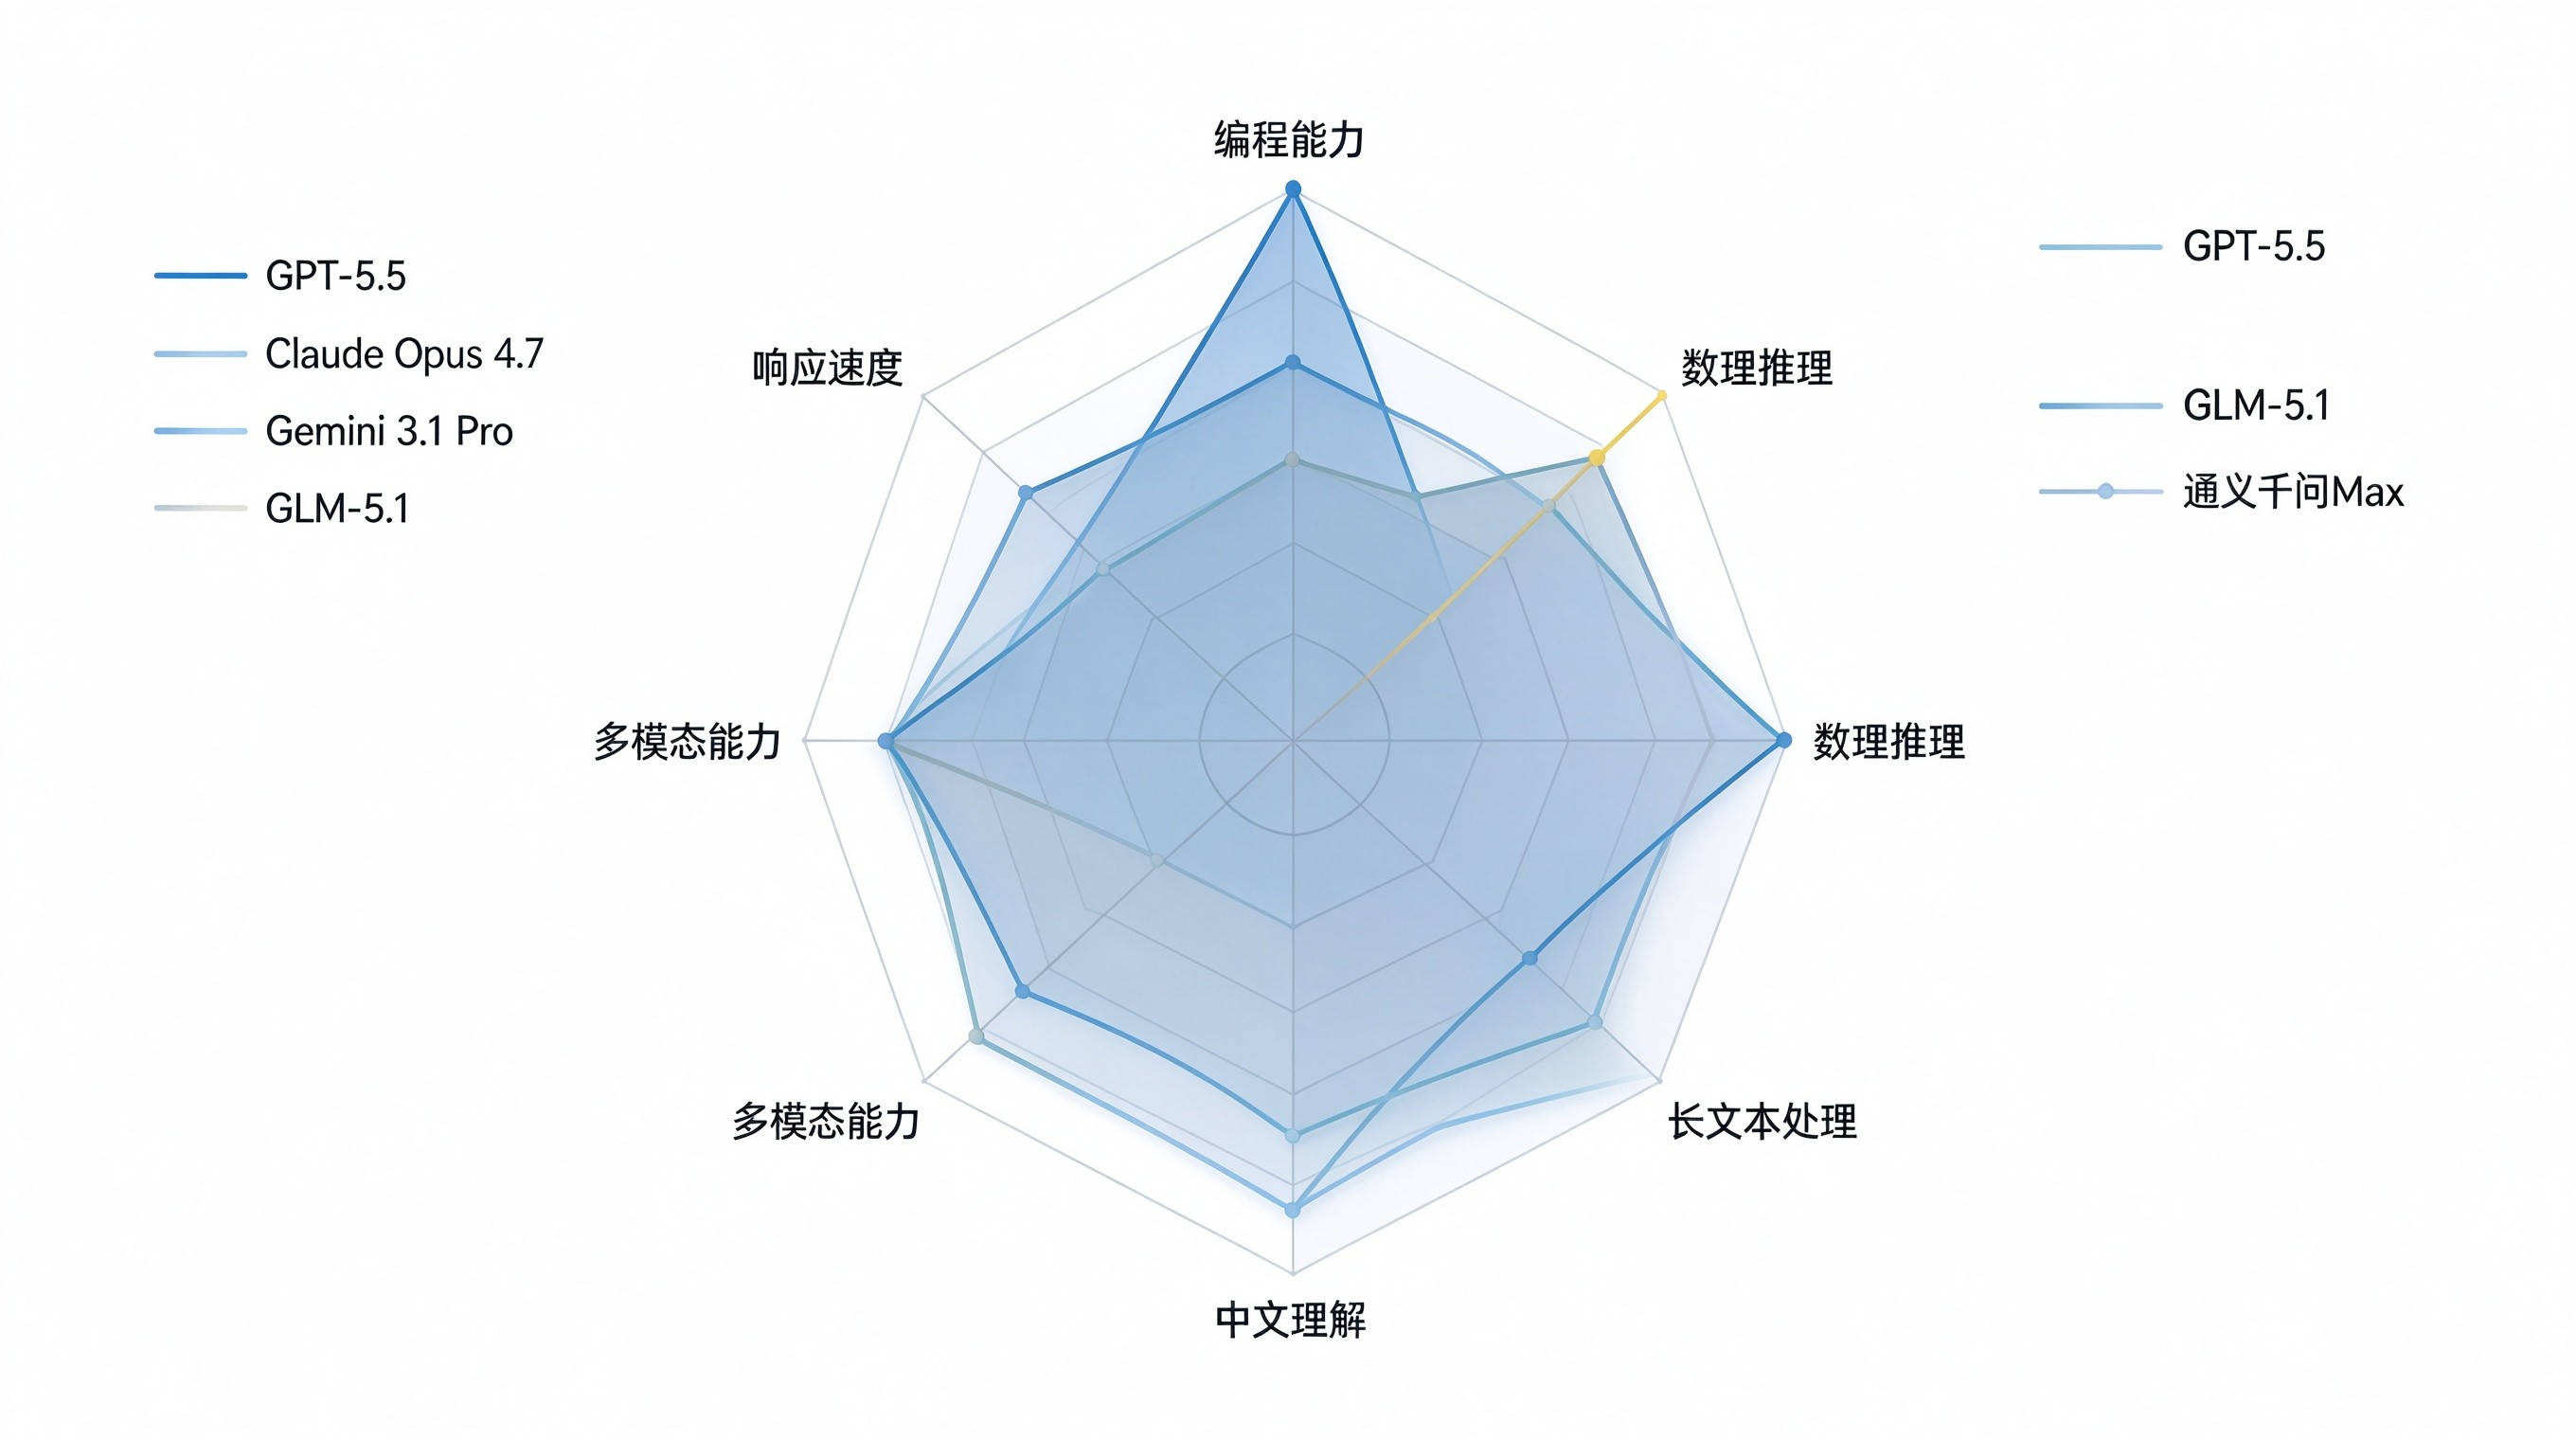
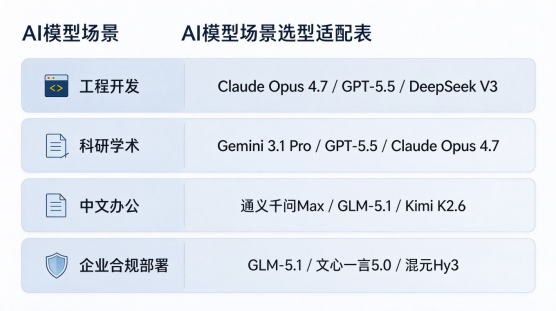
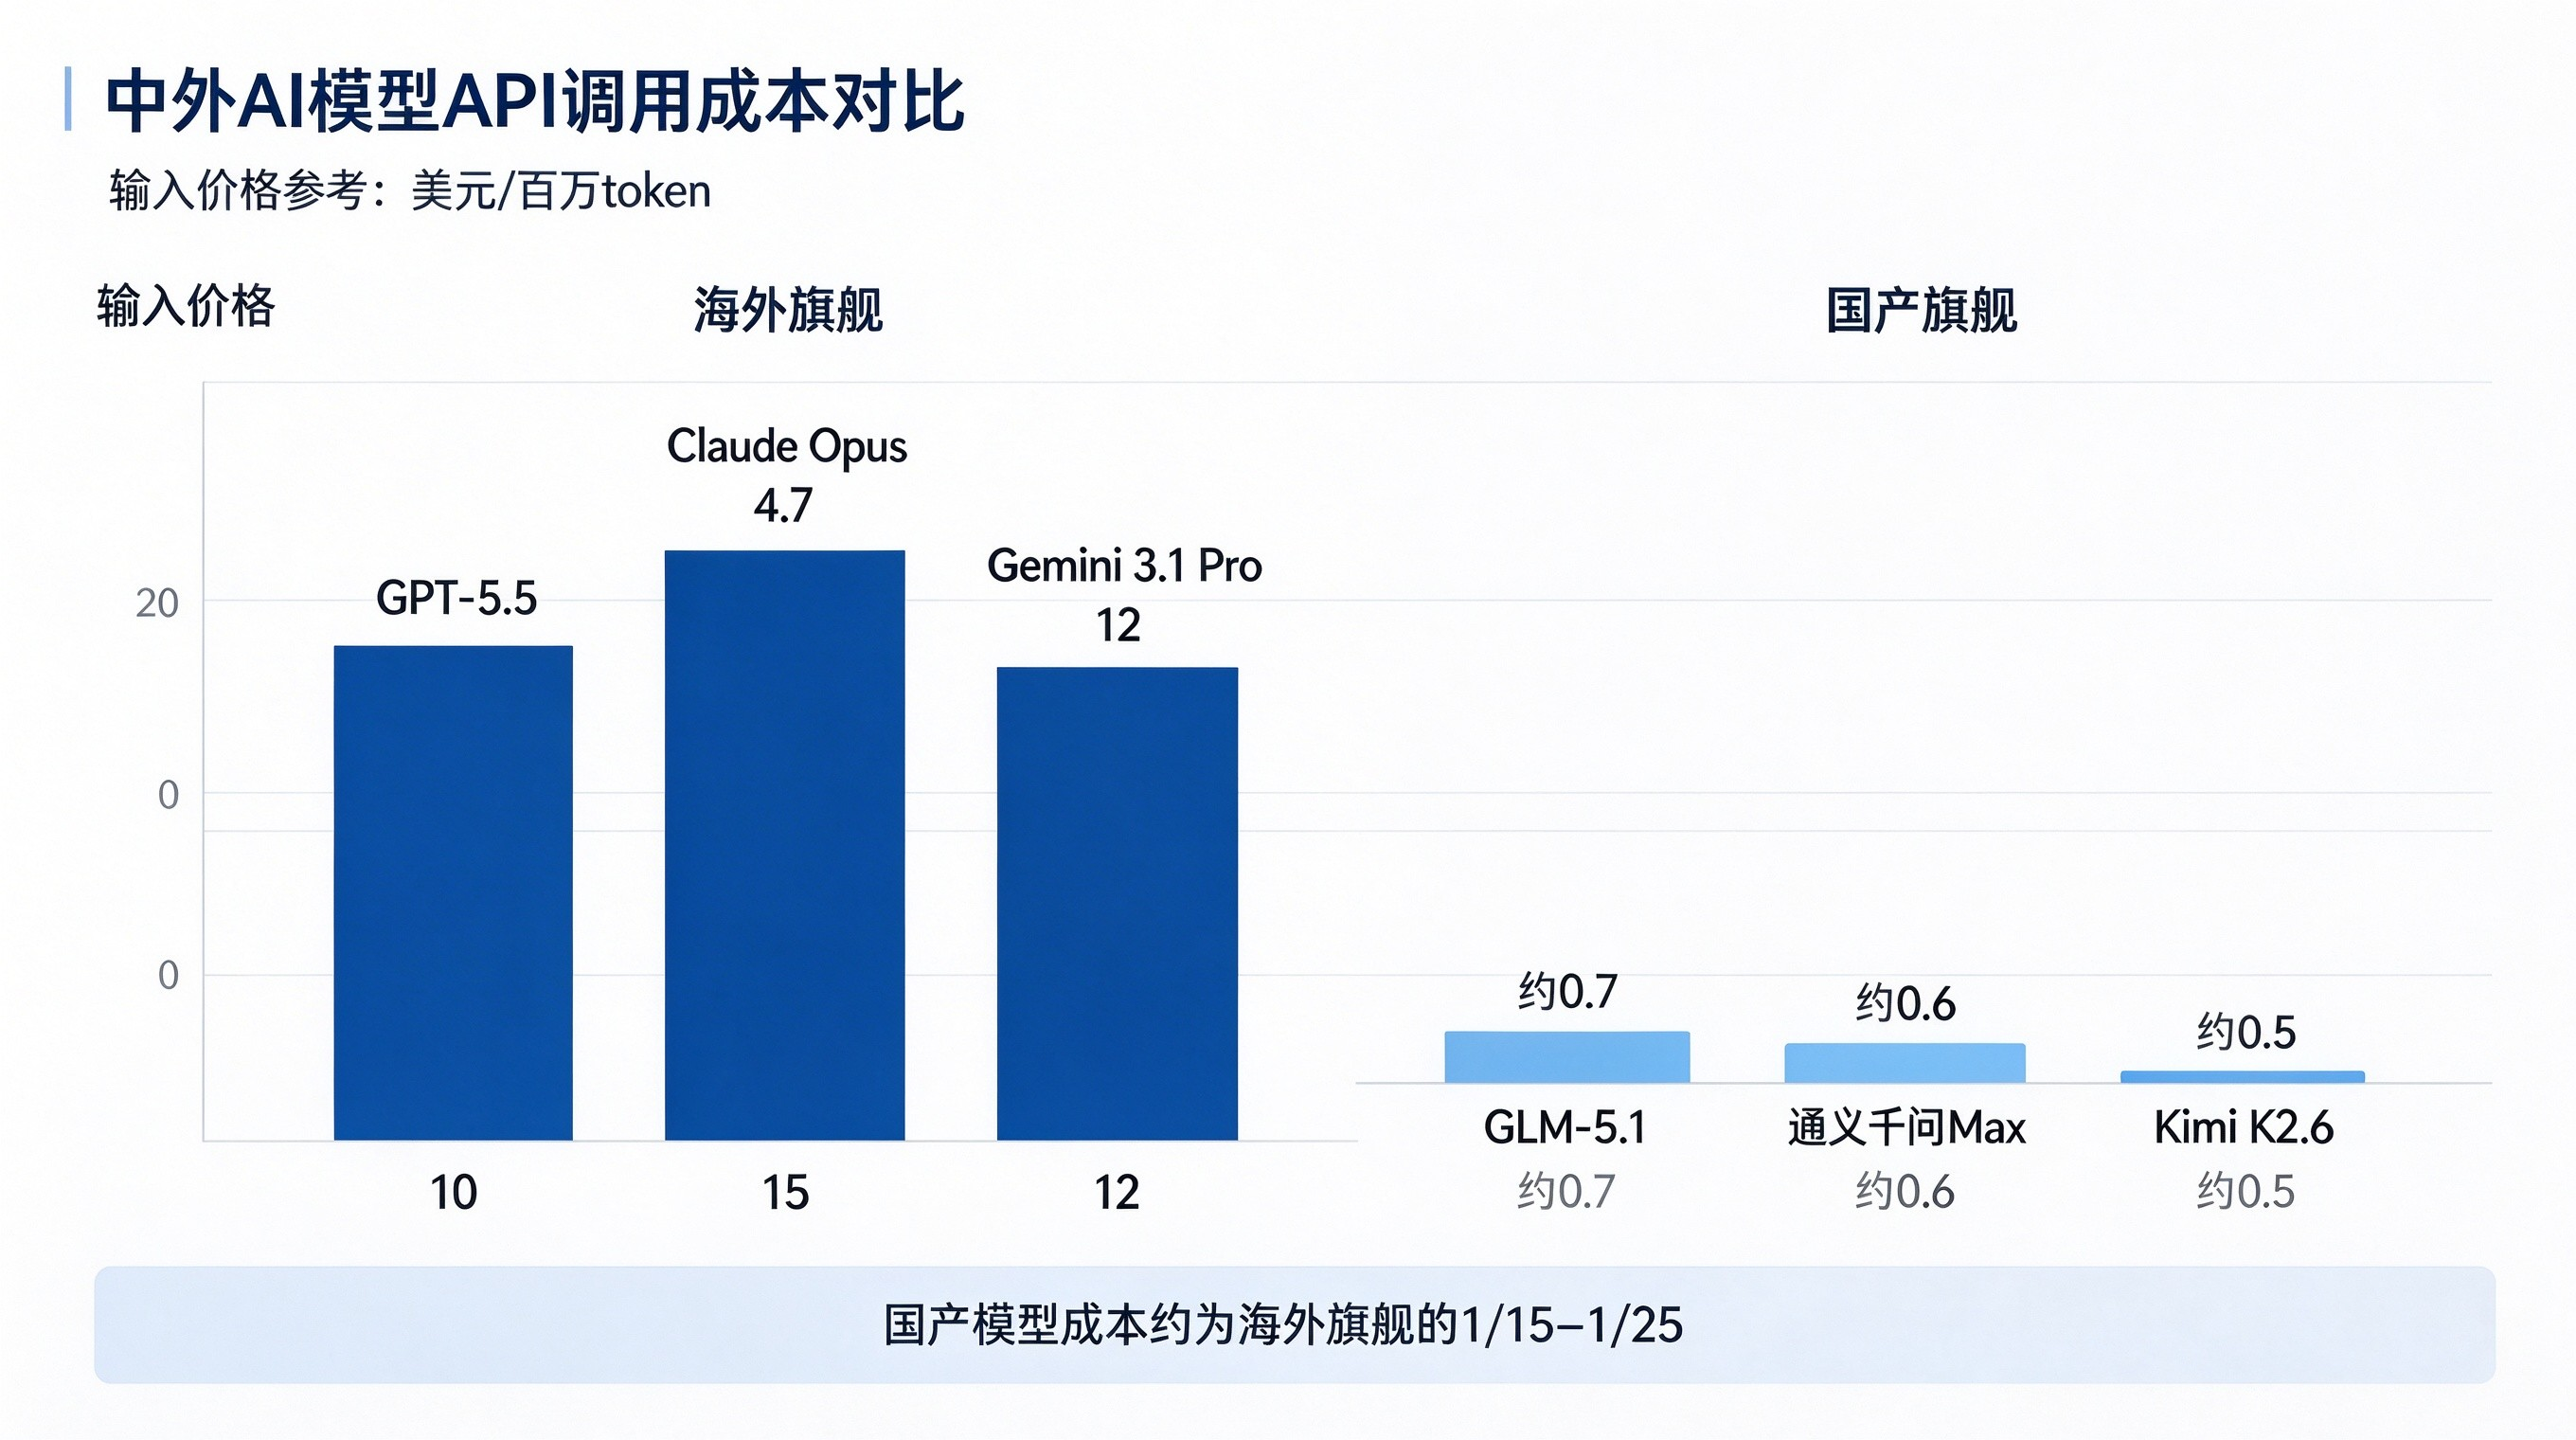
2026年,人工智能大模型的竞争彻底告别“参数堆砌”的粗放时代,进入精细化能力比拼、场景落地为王、成本合规优先的全新阶段。海外旗舰模型持续迭代技术上限,国产头部模型实现跨越式突破,成功跻身全球第一梯队,打破海外长期垄断格局。如今市场不再有“万能最强AI”,不同模型在推理、编程、长文本、多模态、中文适配等维度各有专精。本文依托GPQA Diamond、SWE-bench Pro、SuperCLUE等权威基准测试数据,结合真实场景实测,全面对比国内外主流AI大模型的核心战力、场景适配性、成本与部署优势,为个人使用、企业选型、开发者落地提供客观可落地的参考依据。 一、整体梯队格局:三级分层,国产跻身顶尖阵营 结合2026年最新综合评测数据,主流AI大模型可清晰划分为三大梯队,梯队间核心能力差距显著,梯队内各模型差异化优势突出,形成“海外领跑高端技术,国产深耕本土落地”的多极格局。 第一梯队:综合得分90+,全球顶级旗舰 该梯队模型覆盖全球顶尖技术能力,综合实力断层领先,主打极致推理、工程落地与复杂场景适配,包含海外三巨头与两款国产标杆模型:Anthropic Claude Opus 4.7(95.0分)、OpenAI GPT-5.5(94.8分)、Google Gemini 3.1 Pro(92.1分)、智谱GLM-5.1(90.5分)、阿里通义千问Qwen3-Max(89.7分)。其中,国产GLM-5.1、Qwen3-Max的崛起,标志着中国大模型正式迈入全球顶尖行列。 第二梯队:综合得分80-90分,商用主力模型 以高性价比、垂直场景优化为核心优势,是企业商用、日常办公的主流选择。海外代表为Grok 4.3、DeepSeek V3、Mistral Large 2,侧重工具调用与专业场景深耕;国产代表包含Kimi K2.6、文心一言5.0、腾讯混元Hy3,在中文适配、长文本处理、合规部署上优势明显,适配国内绝大多数商用场景。 第三梯队:综合得分70-80分,轻量化开源模型 主打轻量化、低成本、可私有化部署,适合边缘设备、轻量化开发、小规模微调场景,代表模型有ChatGLM3-6B、Qwen-7B、Llama 4 Maverick,核心价值在于普惠化落地与定制化开发。 图1 2026主流AI大模型三级梯队格局图 二、核心能力硬核对比:六大维度数据定强弱 抛开笼统的综合排名,从用户与行业最关注的六大核心维度实测数据切入,可精准看清各模型的真实优劣与能力边界。 1. 编程能力:Claude断层领跑,国产快速追赶 编程是大模型工程落地的核心硬指标,依托SWE-bench Pro、HumanEval权威测试,Claude Opus 4.7以64.3%的得分稳居业界第一,在大型项目架构设计、复杂BUG修复、工程级代码落地中拥有断层优势,也是目前开发者工具适配度最高的模型。GPT-5.5以61.5%紧随其后,擅长多语言复杂算法实现、逻辑严谨的程序开发,通用性最强。 Gemini 3.1 Pro(58.2%)在AI框架适配、科学计算代码领域表现突出。国产模型中,GLM-5.1(54.9%)、DeepSeek V3.2(53.7%)进步显著,虽与海外旗舰仍有差距,但完美适配国内后端开发、移动端开发、企业级项目落地的技术栈需求,本土化编程适配更具优势。 2. 数理逻辑推理:双强对峙,国产追平顶尖水平 数理与科学推理是衡量模型智商的核心标准,GSM8K数学测试、GPQA Diamond科学推理测试数据显示,GPT-5.5(GSM8K 94.2%、GPQA 93.5%)多步骤逻辑推理精准,链条完整,擅长复杂数理推导与综合问题求解。Claude Opus 4.7(GSM8K 93.8%、GPQA 94.2%)科学推理能力略胜一筹,逼近人类博士专家水准,适合科研级逻辑推演。 值得关注的是,国产通义千问QwQ-32B、DeepSeek R2的GSM8K得分均突破93%,在基础数理推理场景已追平海外顶尖模型,仅在超复杂交叉学科推理上存在小幅差距。 3. 长文本处理:Claude独一档,国产Kimi比肩旗舰 长文本解析、摘要、逻辑梳理是办公、科研、法务场景的核心需求。实测20万字超长文档处理能力中,Claude Opus 4.7凭借200万字超大上下文窗口,以9.8分的满分级表现稳居第一,超长文档无信息遗漏、逻辑无断裂,适配合同审核、专著梳理、大型项目文档复盘等场景。 GPT-5.5支持128万字上下文,综合得分8.9分,稳定性出色,适合常规论文、行业报告处理。国产Kimi K2.6同样支持200万字上下文,实测得分9.0分,中文长文档解析能力优于绝大多数海外模型,是国内长文本办公场景的最优选择之一。 4. 中文语境理解:国产全面碾压海外模型 这是国产模型最核心、最不可替代的优势。基于SuperCLUE、C-Eval中文专项测试,GLM-5.1、通义千问Max、文心一言5.0等国产旗舰模型,SuperCLUE得分稳定70+、C-Eval准确率超84%。在古诗词赏析、方言解析、政务公文创作、网络语义理解、中文歧义句处理等本土化场景中,精准度远超海外模型。 反观GPT-5.5、Claude Opus 4.7,虽基础中文表达流畅,但对中国文化语境、本土政策表述、网络热梗、公文格式的理解存在明显短板,极易出现表述生硬、理解偏差等问题,无法适配专业中文办公与创作场景。 5. 多模态能力:Gemini领跑,GPT均衡,国产商用达标 在图片OCR、表格解析、音视频内容理解等多模态场景中,Google Gemini 3.1 Pro凭借原生多模态架构,以9.8分登顶,复杂图表识别、音视频解析、图文联动理解能力行业顶尖。GPT-5.5以9.4分紧随其后,多模态能力均衡,OCR精度高,适合图文内容创作、素材解析等通用场景。 国产文心一言5.0、通义千问Max已完全满足商用级多模态需求,表格解析、图片识别、图文创作精准稳定,且响应延迟更低,适配国内电商、教育、办公等本土化多模态场景。 6. 响应速度与稳定性:国产低延迟优势突出 实测500字输入单轮响应延迟数据显示,Gemini 3.1 Pro平均延迟0.8s,速度位列第一;GPT-5.5延迟1.1s,稳定性极强,无卡顿、无闪退。国产Qwen3-Max、GLM-5.1延迟控制在0.9-1.0s之间,并发承载能力更强,企业级服务稳定性高,在高并发商用场景中,响应速度与容错率优于海外模型。 图2 五大旗舰AI模型六维能力雷达对比图 三、场景适配选型:不同需求对应最优AI模型 2026年AI选型的核心逻辑不再是“选最强”,而是“选最适配”。结合各模型核心优势,不同场景的最优选择已十分清晰。 1. 技术开发、工程落地 极致工程能力选Claude Opus 4.7,适配大型项目架构设计、全流程代码开发、复杂BUG批量修复;复杂算法、多语言开发选GPT-5.5;国内本土化技术栈开发、低成本商用开发选DeepSeek V3。 2. 科研学术、专业推理 物理、化学、生物等前沿自然科学研究首选Gemini 3.1 Pro,科学推理能力对标行业专家;论文撰写、文献综述、交叉学科研究首选GPT-5.5;超长学术文献梳理、科研数据复盘首选Claude Opus 4.7。 3. 中文办公、内容创作、公文处理 政务公文、新媒体文案、本土化内容创作首选通义千问Max、GLM-5.1;超长合同、标书、行业报告审核梳理首选Kimi K2.6、Claude Opus 4.7,兼顾精准度与效率。 4. 企业合规、私有化部署 金融、政务、国企等敏感场景,优先选择国产全系列模型(GLM-5.1、文心一言5.0、腾讯混元Hy3),支持本地私有化、混合云部署,数据全程不出境,完全符合国内合规要求;海外模型仅支持云端API调用,存在数据出境风险,无法适配涉密场景。 图3 AI模型场景选型适配对照表 四、成本与部署对比:国产模型性价比碾压海外旗舰 在企业规模化落地中,调用成本与部署灵活性是核心考量因素,国产模型在此维度形成压倒性优势。 1. API调用成本(2026年最新定价) 海外旗舰模型定价高昂,GPT-5.5为输入10美元/百万token、输出30美元/百万token,Claude Opus 4.7为输入15美元/百万token、输出45美元/百万token,规模化调用成本极高。 国产旗舰模型成本仅为海外的1/16-1/22,通义千问Max、GLM-5.1调用成本为输入5元/百万token、输出20元/百万token,性价比优势显著。而Qwen3-72B、Llama 4 Maverick等开源轻量模型,可免费开源部署,仅需承担算力成本,适配预算有限的轻量化项目。 图4 中外AI模型API调用成本对比图 2. 部署灵活性 海外GPT、Claude、Gemini模型仅支持官方云端API调用,部署模式单一,数据必须出境,合规风险高,无法适配国内涉密、敏感行业。国产模型全系列支持云端调用、本地私有化部署、混合云部署等多种模式,部署灵活、数据安全可控,完美适配国内各类企业、政务场景的落地需求。 五、2026年AI模型对比总结与未来趋势 综合全年实测数据与落地表现,当前全球AI大模型格局已形成“海外领跑技术上限,国产掌控本土落地”的稳态格局。Claude、GPT、Gemini组成的海外第一梯队,在复杂推理、工程编程、前沿科研领域仍保持技术壁垒;而以智谱、通义、文心一言、腾讯混元为代表的国产模型,凭借极致的中文适配、超高性价比、合规可控的部署优势,牢牢占据国内商用与政务市场,综合实力已跻身全球顶尖行列。 行业趋势层面,2026年AI发展彻底摒弃“唯参数论、唯跑分论”,场景适配度、成本可控性、安全合规性成为衡量模型价值的核心标准。未来,海外模型将持续突破通用AI技术上限,深耕高端科研与复杂工程场景;国产模型将持续补齐高端推理、前沿科研短板,同时进一步强化本土化、低成本、高合规的核心优势,实现从“追赶并跑”向“局部领跑”的跨越。 对于用户与企业而言,最优AI应用策略不再是单一依赖某一款旗舰模型,而是多模型组合适配:高端复杂任务选用海外旗舰模型,中文办公、商用落地、合规场景选用国产模型,轻量化需求搭配开源模型,实现能力、成本、安全的最优平衡。 |
上一篇:内容营销的10个方法论
下一篇:没有了
 贵公网安备52010302003427号

 手机版


 热门文章
 最新文章
 推荐阅读